食材配送EPR管理软件选型:从订单到分拣的波峰压力测试方案
2026-11-05 09:30:53食材配送系统的选型,功能清单的比对只是起点。真正决定系统能否在每日凌晨的截单窗口和节前爆单中“扛得住”的,是订单入口到分拣出库这条链路上的容量一致性。一笔订单在系统里存活的时间很短,但它经过的每一个环节 下单校验、库存预占、波次生成、任务下发、分拣复核 各自有不同的吞吐上限。压测的意义,就是在选型阶段把这条链路的“最先触顶节点”找出来,而不是等洪峰到来时用临时加机器去赌。
一、波峰压力的真实形状:不是均匀的“大”,而是结构性的“挤”
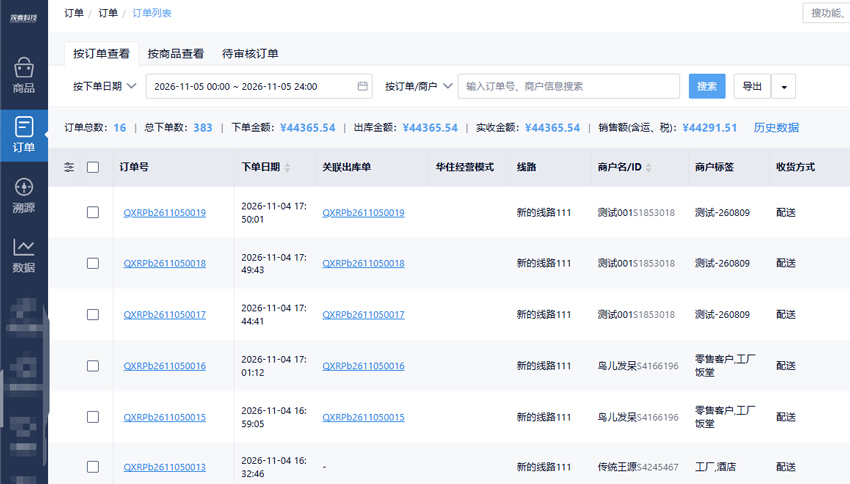
食材配送的波峰具有三个可量化的特征,直接决定了压测场景的设计逻辑。时间集中:B端食堂客户的截单时间高度趋同,晚10点至次日凌晨1点往往承载全天60%以上的订单创建量,波峰系数可达日均小时值的8—15倍。SKU与区域集中:同一线路、同一品类(如叶菜、根茎、肉禽)的订单在波峰时段高度重叠,单仓单线的分拣工位压力被成倍放大。时效刚性:分拣必须在司机到仓前完成,错过分拣截止点意味着整条配送线路的延误,没有“稍后重试”的空间。
这意味着压测不能只测“系统能接多少单”,而要测“接住的单能不能在截止时间前被分拣出来”。行业实践中,全链路压测的流量应覆盖峰值预估的1.2至1.5倍,并盯住三个履约级指标:订单创建成功率、仓内出库及时率、分拣错漏率。
二、从订单到分拣的压测场景设计
压测场景需要按链路拆解,而不是用一个笼统的并发数一压到底。建议按以下四段设计混合场景:
第一段:订单入口压测。 模拟截单前30分钟的集中下单,混合正常单、加急单、修改单、取消单,验证订单创建接口的P99响应时间与限流策略是否触发合理。行业参考基线:订单提交响应时间≤2秒,系统级TPS目标不低于5000。
第二段:库存与波次压测。 在订单持续涌入的同时,观察库存预占的幂等性与波次生成引擎的排队行为。这一段的瓶颈往往不在“算得快不快”,而在“锁争用是否导致订单状态卡在中间态”。压测中应专门注入重复提交和并发修改库存的流量,验证预占—确认两阶段机制是否守住不超卖底线。
第三段:分拣任务下发与执行压测。 这是食材配送系统区别于通用ERP的核心段。波次生成后,分拣任务需要按工位、按品类分片下发,PDA端或分拣屏的刷新延迟直接传导为分拣员等待。压测指标应落在单工位任务队列深度和任务端到端下发延迟上,而非单纯看接口TPS。分拣峰值期的错分率是另一个不能忽略的软指标:行业日常错分率约0.1%—0.3%,大促峰值期可攀升至1%—2%,系统选型时应要求厂商提供波峰场景下的分拣准确率实测数据,而非仅展示日常基线。
第四段:混合稳态与恢复压测。 在峰值流量持续30—60分钟后,突然撤走50%流量,观察系统是否能从队列积压中平稳消费、库存状态是否出现不一致、波次任务是否残留。这一步检验的是异步削峰架构的“消化能力”,而非“抗压能力”。
三、选型对比:SaaS与本地部署在波峰场景下的真实差异
将压测视角带入选型决策,SaaS与本地部署的差异不在于“功能有没有”,而在于峰值弹性的获取方式和成本结构。下表拉齐到三年TCO与波峰承载维度进行对比:
| 对比维度 | 行业SaaS(日单100—5000单场景) | 本地部署/私有化(日单500单以上或强合规场景) |
|---|---|---|
| 峰值承载方式 | 依赖厂商分布式架构的共享弹性,峰值吞吐受套餐档位与限流策略约束;头部厂商自研架构可覆盖5000—6000单峰值区间 | 承载上限由企业自购硬件与架构设计决定,弹性扩容需提前采购服务器,响应周期以天/周计 |
| 压测可执行性 | 厂商侧全链路压测能力是关键考察项;企业难以自行对共享集群做破坏性压测 | 可自主搭建影子库与影子表进行数据隔离压测,测试深度可控 |
| 分拣环节适配 | 标准分拣模块按波次下发,对“按商品分拣(播种式)”的汇总算力依赖厂商SaaS层的批处理能力 | 可针对自有分拣线做深度定制,播种墙接口、PDA任务分片策略可随业务节奏调整 |
| 三年TCO参考 | 基础版年费3—5万元,标准版5—8万元;日单数百单时三年总成本约5万+元 | 软件买断30万+元,硬件与实施另计,入门级三年总成本10万元起步;年订单超50万单后固定成本才逐步摊薄 |
| 波峰扩容成本 | 按单量或套餐档位阶梯计费,峰值月可能产生额外费用;合同是否设封顶是关键条款 | 扩容即资本支出,需提前规划,但边际成本随单量增长递减 |
| 适用判断 | 日单量尚未稳定超过500单、缺乏专职IT运维、希望以最低前期投入跑通波峰流程的企业 | 日单量持续高位、数据合规要求物理隔离、或分拣模式需要与自动化设备深度集成的企业 |
一个容易被忽视的选型陷阱是:SaaS厂商演示的“峰值6000单”是在其标准集群上的理想数据,而你的实际峰值可能叠加了多仓并发、批量导入、API对接等多路流量。压测方案中应要求厂商提供与你业务结构相似的参考客户在波峰日的真实监控截图,而非实验室数据。
四、实施策略:把压测变成选型的决策工具
建议在选型POC阶段执行三轮递进式压测。
第一轮用JMeter或Locust对候选系统的订单创建、库存扣减、波次生成三个接口做基础容量摸底,确认各自的TPS拐点与P99延迟拐点。
第二轮注入“混合异常流量” 重复提交、库存并发修改、分拣任务超时重派 观察系统的幂等设计与熔断降级是否按预期工作。
第三轮做短时峰值冲击(30分钟1.5倍预估峰值),随后立即撤压,检查队列积压消化时间和数据一致性。
三轮之后,候选系统之间的差距往往不在“谁扛的单多”,而在“谁在压力下状态最不容易乱”。
FAQ问答
Q1:压测环境用生产数据还是构造数据?影子表方案对食材配送系统适用吗?
构造数据容易低估SKU行数、订单拆合规则和库存关联关系的复杂度。推荐在隔离环境导入脱敏后的近期真实订单做基线。全链路压测中,影子表(影子库)方案通过流量染色将压测请求路由到影子 schema,业务数据库不受污染,在食材配送场景完全可行;关键在于中间件和MyBatis拦截器能否完整透传压测标识,而不是在某一层丢失染色导致数据写穿。
Q2:订单接口压测过了,为什么分拣环节仍然可能崩?
因为订单TPS和分拣吞吐量是两个独立的容量维度。订单落库是毫秒级写操作,分拣是分钟级人机协同作业。压测中订单接口达标只说明“入口通畅”,不代表波次生成后的任务分片、PDA下发、复核回传能同节奏消化。分拣段的压测必须单独设计,指标要落到单工位任务队列深度和波次完成率上。
Q3:SaaS系统在波峰时被其他租户“挤”了怎么办?
这是SaaS选型中真实存在的风险,但可以通过合同条款和技术架构来缓释。选型时应确认厂商是否具备租户级隔离的限流与资源配额,而不是所有租户共享一个无差别的资源池。更务实的做法是:在合同中约定波峰时段的SLA(如订单创建P99≤2秒、分拣任务下发延迟≤5秒),并要求厂商提供压测报告或参考客户的波峰监控数据作为附件。
Q4:预算有限,能不能先上SaaS,等单量大了再迁本地部署?
可以,但迁移成本取决于数据可导出性和系统耦合深度。订单、客户、商品主数据通常能导出,但库存状态、波次配置、分拣工位映射等关联关系需要在迁移中重建验证;并行期间还会产生人力重叠成本。如果选择这条路径,应在SaaS合同中提前写入数据导出格式与迁移协助条款,把后期补救成本前置锁定。混合部署(核心数据本地、弹性应用上云)是折中选项,但对供应商架构能力要求更高。
Q5:如何判断厂商演示的“高并发”数据是不是“伪压测”?
问三个问题即可过滤大部分水分:压测流量中写操作占比多少(纯查询压测的数字没有意义);压测是否覆盖了库存预占与分拣任务下发这两个食材配送特有的重环节;压测期间是否同时运行着其他租户的生产流量(SaaS场景下,隔离环境的数字不等于共享环境的表现)。真正做过全链路压测的厂商,能给出分环节的TPS、P99和队列积压曲线,而不是一个孤立的“峰值单量”数字。


 售前咨询
 意见建议
 加盟合作
 1对1微信客服